ꯔꯨꯂꯦꯠ ꯆꯛꯔꯒꯤ ꯕꯥꯏꯌꯥꯁ ꯀꯔꯝꯅ ꯊꯤꯗꯣꯛꯀꯅꯤ
ꯏꯕ, ꯃꯁꯤꯡ ꯊꯤꯕ, ꯇꯦꯁ꯭ꯠ ꯇꯧꯕ, ꯃꯇꯨꯡꯗ ꯍꯦꯟꯅꯥ ꯏꯕ: ꯔꯨꯂꯦꯠ ꯆꯛꯔꯒꯤ ꯕꯥꯏꯌꯥꯁ ꯊꯤꯗꯣꯛꯄꯒꯤ ꯃꯑꯣꯡ ꯑꯗꯨ ꯃꯁꯤꯅꯤ꯫
Use a reliable record from one identified wheel, choose the test before inspecting results, and confirm any finding with independent data. Sample size depends on the effect you want to detect.
1. ꯏꯕ
Record every outcome from one identified wheel, with dates and any known equipment changes. Missing rounds and changes of wheel can distort the analysis. There is no universal 1,000-spin minimum: validity and power depend on the test and the effect being studied.
2. ꯃꯁꯤꯡ ꯊꯤꯕ ꯑꯃꯁꯨꯡ ꯇꯦꯁ꯭ꯠ ꯇꯧꯕ
For a fair single-zeroꯆꯛꯔꯖꯤꯔꯣꯆꯞ ꯃꯥꯟꯅꯕ, ꯗꯖꯟ ꯅꯠꯔꯒ ꯀꯂꯝ ꯕꯦꯠ ꯑꯃꯠꯇꯅ ꯀꯨꯞꯇꯕ ꯑꯁꯪꯕ ꯄꯣꯀꯦꯠ ꯑꯃꯈꯛꯇ; ꯍꯥꯎꯁ ꯑꯦꯖꯀꯤ ꯍꯧꯔꯀꯐꯝꯅꯤ꯫ ꯑꯇꯣꯞꯄ ꯃꯃꯤꯡ: ꯁꯤꯡꯒꯜ ꯖꯤꯔꯣ, 0꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → wheel, expected hits are n/37 per pocketꯈꯨꯠꯂꯥꯏꯄꯣꯀꯦꯠꯔꯣꯇꯔꯗ ꯂꯩꯕ ꯃꯁꯤꯡ ꯏꯔꯕ ꯀꯣꯠ 37 ꯒꯤ ꯃꯅꯨꯡꯗ ꯑꯃꯥ꯫ ꯑꯇꯣꯞꯄ ꯃꯃꯤꯡ: ꯁ꯭ꯂꯣꯠ, ꯀꯞ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →. Sum (observed − expected)² / expected across all 37 pockets. Under independent uniform spins, compare the result with an approximate chi-square distribution on 36 degrees of freedomꯂꯦꯕꯗꯤꯒ꯭ꯔꯤ ꯑꯣꯐ ꯐ꯭ꯔꯤꯗꯝꯁ꯭ꯇꯦꯇꯤꯁ꯭ꯇꯤꯛ ꯑꯃꯗ ꯃꯔꯤ ꯂꯩꯅꯗꯕ ꯚꯦꯂꯨꯁꯤꯡꯒꯤ ꯃꯁꯤꯡ꯫ ꯄꯣꯀꯦꯠ 37 ꯒꯤ ꯀꯥꯏ-ꯁ꯭ꯀ꯭ꯋꯦꯌꯔ ꯇꯦꯁ꯭ꯠ ꯑꯃꯗ ꯃꯁꯤ 36 ꯅꯤ, ꯃꯔꯃꯗꯤ ꯊꯤꯕ ꯃꯁꯤꯡꯁꯤꯡ ꯄꯨꯟꯁꯤꯟꯂꯕꯗ ꯃꯄꯨꯡ ꯑꯗꯨ ꯑꯣꯏꯒꯗꯕꯅꯤ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →. Choose any extra pocket or sectorꯆꯛꯔꯁꯦꯛꯇꯔꯆꯛꯔꯗ ꯃꯔꯛ ꯂꯩꯇꯅ ꯃꯈꯥ ꯆꯠꯅꯅ ꯂꯩꯕ ꯄꯣꯀꯦꯠꯁꯤꯡꯒꯤ ꯁꯔꯨꯛ, ꯂꯦꯑꯥꯎꯠꯇ ꯂꯩꯕ ꯀꯥꯡꯂꯨꯞ ꯑꯃꯗꯒꯤ ꯇꯣꯉꯥꯟꯅ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → tests in advance.
3. ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯕ
A second independent sample checks whether the finding persists. Real effects can fail to reach significance again, and chance findings can recur. If you splitꯕꯦꯠꯁ꯭ꯞꯂꯤꯠꯌꯨꯝꯂꯣꯟꯅꯕ ꯃꯁꯤꯡ ꯑꯅꯤ, 17:1 ꯄꯦꯑꯥꯎꯠ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → a record, keep the confirmation half unseen while choosing the hypothesis on the first half. Account for all tests tried.
4. ꯊꯧꯒꯜ ꯑꯗꯨꯒꯤ ꯆꯥꯡ ꯊꯥꯖꯕ
On a 35:1 straight-up payoutꯁꯦꯜꯄꯦꯑꯥꯎꯠꯃꯥꯏꯄꯥꯛꯄ ꯕꯦꯠ ꯑꯃꯅ ꯍꯜꯂꯛꯄ ꯁꯦꯜ, ꯍꯜꯂꯀꯄ ꯊꯝꯂꯕ ꯁꯦꯜꯒꯤ ꯃꯊꯛꯇ “X ꯗꯒꯤ 1” ꯍꯥꯌꯅ ꯍꯥꯌꯏ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →, expected net return per unitꯁꯦꯜꯌꯨꯅꯤꯠꯁꯤꯁ꯭ꯇꯦꯝ ꯅꯠꯔꯒ ꯁꯥꯟꯅꯔꯤꯕ ꯑꯃꯅ ꯁꯤꯖꯤꯟꯅꯕ ꯃꯔꯨꯑꯣꯏꯕ ꯊꯝꯂꯕ ꯁꯦꯜ꯫ ꯄ꯭ꯔꯣꯒ꯭ꯔꯦꯁꯅꯁꯤꯡ ꯌꯨꯅꯤꯠꯇ ꯁꯟꯗꯣꯛꯂꯤ, ꯃꯔꯝ ꯑꯗꯨꯅ ꯃꯈꯣꯌ ꯀꯔꯤꯒꯨꯝꯕ ꯇꯦꯕꯜꯗ ꯆꯠꯂꯤ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → is 36p − 1. A true hit probabilityꯃꯦꯊꯃꯦꯇꯤꯛꯁꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕꯃꯍꯩ ꯑꯃꯥ ꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ, 0 ꯗꯒꯤ 1 ꯐꯥꯑꯣꯕ ꯅꯠꯔꯒ 0% ꯗꯒꯤ 100% ꯐꯥꯑꯣꯕ꯫ ꯃꯁꯤꯡ ꯑꯃꯥ: 1/37 = 2.70%꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → of 1/36 breaks even; profitability requires more. An observed rate is an estimate with uncertainty, especially if you chose the hottest pocket after seeing the data.
ꯃꯇꯨꯡꯗ ꯀꯔꯤ: ꯑꯅꯧꯕ ꯀꯦꯁꯤꯅꯣꯁꯤꯡꯗ ꯔꯨꯂꯦꯠ ꯆꯛꯔꯒꯤ ꯕꯥꯏꯌꯥꯁ ꯊꯤꯗꯣꯛꯄ
A statistical finding alone does not identify its physical cause or guarantee that the pattern will persist. Recording errors, changing equipment and changing operating conditions need investigation. Historical examples are covered separately; no maintenance schedule guarantees that every possible bias is detected first.
ꯃꯃꯤꯡ ꯂꯩꯔꯕ ꯔꯨꯂꯦꯠ ꯁꯥꯟꯅꯔꯤꯕꯁꯤꯡꯒꯣꯟꯖꯥꯂꯣ ꯒꯥꯔꯁꯤꯌꯥ-ꯄꯦꯂꯥꯌꯣ: ꯔꯨꯂꯦꯠ ꯁꯤꯁ꯭ꯇꯦꯝ
ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠ ꯑꯃꯥ ꯃꯇꯝ ꯄꯨꯝꯅꯃꯛꯇ ꯂꯩ
ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠ ꯑꯗꯨ ꯈꯅꯗꯨꯅ ꯃꯁꯤ ꯈꯛꯇ ꯇꯦꯁ꯭ꯠ ꯇꯧꯕ ꯑꯁꯤ ꯂꯥꯡ ꯑꯃꯅꯤ, ꯃꯔꯃꯗꯤ ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯗ ꯃꯇꯝ ꯄꯨꯝꯅꯃꯛꯇ ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠ ꯑꯃꯥ ꯂꯩ꯫ ꯁ꯭ꯄꯤꯟ 3,700 ꯒꯤ ꯃꯇꯨꯡꯗ ꯄꯣꯀꯦꯠ ꯈꯨꯗꯤꯡꯃꯛꯇ ꯂꯥꯀꯄ 100 ꯐꯪꯒꯗꯕꯅꯤ, ꯑꯗꯨꯕꯨ ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯀꯄ ꯑꯗꯨꯅ ꯃꯇꯝ ꯌꯥꯝꯅ 122 ꯃꯇꯧ ꯎꯠꯂꯤ, ꯑꯃꯁꯨꯡ ꯁꯦꯝꯄꯜ ꯀꯨꯟꯗ ꯑꯃꯗ 131 ꯅꯠꯔꯒ ꯍꯦꯟꯅꯥ ꯎꯠꯂꯤ꯫ ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯍꯟꯊꯕ ꯑꯗꯨꯅ ꯃꯇꯝ ꯌꯥꯝꯅ 79 ꯃꯇꯧ ꯎꯠꯂꯤ꯫ ꯃꯔꯝ ꯑꯗꯨꯅ ꯁ꯭ꯄꯤꯟ 3,700 ꯗ 125 ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠ ꯑꯃꯥ ꯊꯤꯗꯣꯛꯄ ꯑꯃꯥ ꯅꯠꯇꯦ: ꯃꯁꯤꯕꯨ 100 ꯒ ꯅꯠꯇꯅ ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯒꯤ ꯈ꯭ꯕꯥꯏꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠꯀꯥ ꯆꯥꯡꯗꯝꯕꯤꯌꯨ꯫
ꯃꯇꯝ ꯌꯥꯝꯅ ꯊꯣꯀꯄ ꯑꯔꯥꯟꯕꯁꯤꯡ
Do not pool unidentified wheels and interpret the result as a diagnosis of one wheel. Do not choose a sector after seeing the data without accounting for that search. Uniform marginal counts also do not establish independence: a process can have dependence without an obvious pocket-frequency imbalance.
ꯋꯥꯍꯪꯁꯤꯡ
ꯇꯦꯁ꯭ꯠ ꯑꯗꯨ ꯆꯂꯥꯏꯕꯒꯤꯗꯃꯛ 1,000; ꯂꯧꯕꯒꯤ ꯀꯥꯟꯅꯕ ꯂꯩꯕ ꯕꯥꯏꯌꯥꯁ ꯑꯃꯥ ꯊꯤꯗꯣꯛꯅꯕ ꯂꯤꯁꯤꯡ ꯀꯌꯥ; ꯁꯣꯏꯗꯅ ꯇꯥꯛꯅꯕ ꯂꯤꯁꯤꯡ ꯇꯔꯥ ꯀꯌꯥ꯫
ꯃꯁꯤꯅ ꯆꯛꯔ ꯑꯗꯨ ꯈꯉꯍꯜꯂꯕꯗ ꯑꯃꯁꯨꯡ ꯆꯥꯡꯅ ꯁ꯭ꯄꯤꯟ ꯎꯠꯂꯕꯗ ꯈꯛ꯫ ꯌꯥꯝꯕꯥ ꯕꯣꯔꯗꯁꯤꯡꯅ 20 ꯗꯒꯤ 500 ꯐꯥꯑꯣꯕ ꯎꯠꯂꯤ, ꯃꯁꯤ ꯆꯥꯡꯗꯦ꯫
ꯆꯛꯔ ꯑꯗꯨꯅ ꯃꯥꯟꯅꯕ ꯃꯍꯩꯁꯤꯡ ꯄꯤꯗꯕꯥ ꯌꯥꯏ ꯍꯥꯌꯕꯗꯨ꯫ ꯄꯣꯀꯦꯠ ꯑꯃꯅ ꯆꯥꯡꯅ ꯄꯦꯑꯥꯎꯠ ꯄꯤ ꯍꯥꯌꯕ ꯅꯠꯇꯦ, ꯑꯃꯁꯨꯡ ꯃꯑꯣꯡ ꯑꯗꯨ ꯂꯦꯞꯂꯒꯅꯤ ꯍꯥꯌꯕꯁꯨ ꯅꯠꯇꯦ꯫
ꯃꯦꯊꯃꯦꯇꯤꯛꯁꯀꯥ ꯁꯥꯟꯅꯕ
ꯃꯁꯤꯁꯤꯡ ꯑꯍꯥꯅꯕꯗ ꯅꯍꯥꯛ ꯃꯁꯥꯃꯛꯅ ꯍꯣꯠꯅꯕꯤꯌꯨ꯫ ꯄꯥꯎꯈꯨꯝ ꯈꯨꯗꯤꯡꯃꯛ ꯊꯨꯡꯗꯨꯅ ꯊꯝꯂꯤ; ꯁꯦꯝ ꯁꯥꯔꯕ ꯃꯇꯃꯗ ꯍꯥꯡꯗꯣꯛꯄꯤꯌꯨ꯫
Consider a hypothetical outcome distribution with probabilityꯃꯦꯊꯃꯦꯇꯤꯛꯁꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕꯃꯍꯩ ꯑꯃꯥ ꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ, 0 ꯗꯒꯤ 1 ꯐꯥꯑꯣꯕ ꯅꯠꯔꯒ 0% ꯗꯒꯤ 100% ꯐꯥꯑꯣꯕ꯫ ꯃꯁꯤꯡ ꯑꯃꯥ: 1/37 = 2.70%꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → 15/37 for redꯕꯦꯠꯑꯉꯥꯡꯕꯑꯉꯥꯡꯕ ꯃꯁꯤꯡ 18 ꯗ ꯊꯝꯕ ꯆꯞ ꯃꯥꯟꯅꯕ ꯕꯦꯠ꯫ ꯐ꯭ꯔꯦꯟꯆ: ꯔꯨꯖ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →, 21/37 for blackꯕꯦꯠꯑꯃꯨꯕꯑꯃꯨꯕ ꯃꯁꯤꯡ 18 ꯗ ꯊꯝꯕ ꯆꯞ ꯃꯥꯟꯅꯕ ꯕꯦꯠ꯫ ꯐ꯭ꯔꯦꯟꯆ: ꯅꯣꯌꯥꯔ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → and 1/37 for zeroꯆꯛꯔꯖꯤꯔꯣꯆꯞ ꯃꯥꯟꯅꯕ, ꯗꯖꯟ ꯅꯠꯔꯒ ꯀꯂꯝ ꯕꯦꯠ ꯑꯃꯠꯇꯅ ꯀꯨꯞꯇꯕ ꯑꯁꯪꯕ ꯄꯣꯀꯦꯠ ꯑꯃꯈꯛꯇ; ꯍꯥꯎꯁ ꯑꯦꯖꯀꯤ ꯍꯧꯔꯀꯐꯝꯅꯤ꯫ ꯑꯇꯣꯞꯄ ꯃꯃꯤꯡ: ꯁꯤꯡꯒꯜ ꯖꯤꯔꯣ, 0꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →. Red and black bets pay 1:1. Find their expected returns as percentages of the stake.
ꯄꯥꯎꯈꯨꯝ ꯎꯠꯄ
ꯄꯥꯎꯈꯨꯝ ꯑꯉꯥꯡꯕꯅ 18.9% ꯆꯪꯏ; ꯑꯃꯨꯕꯅ 13.5% ꯐꯪꯏ꯫
ꯑꯉꯥꯡꯕꯅ 37 ꯗ ꯑꯃꯨꯛ 15 ꯃꯥꯏꯄꯥꯀꯏ ꯑꯃꯁꯨꯡ 22 ꯃꯥꯏꯊꯤꯕꯏ: (15 − 22)/37 = −18.9%꯫ ꯑꯃꯨꯕꯅ ꯑꯃꯨꯛ 21 ꯃꯥꯏꯄꯥꯀꯏ ꯑꯃꯁꯨꯡ 16 ꯃꯥꯏꯊꯤꯕꯏ: (21 − 16)/37 = +13.5%꯫
ꯕꯥꯏꯌꯥꯁ ꯑꯁꯤꯅ ꯃꯥꯏꯀꯩ ꯑꯅꯤꯃꯛꯇ ꯊꯕꯛ ꯇꯧꯏ꯫ ꯃꯁꯤ ꯂꯦꯞꯈꯤꯕ ꯁꯥꯟꯅꯔꯤꯕꯗ ꯑꯦꯖ ꯄꯤꯔꯤꯕ ꯆꯛꯔ ꯑꯗꯨꯅ ꯑꯔꯥꯟꯕ ꯃꯆꯨꯗ ꯊꯝꯂꯤꯕ ꯁꯥꯟꯅꯔꯤꯕꯗꯒꯤ ꯃꯇꯝ ꯄꯨꯝꯕꯒꯤ ꯃꯃꯂꯗꯒꯤ ꯑꯃꯨꯛ ꯇꯔꯦꯠ ꯂꯧꯏ꯫ Hunacek (2025) ꯅ ꯃꯁꯤꯒꯥ ꯃꯥꯟꯅꯕ ꯈꯨꯗꯝ ꯑꯃꯥ ꯁꯤꯖꯤꯟꯅꯔꯤ꯫
37 ꯗ ꯄꯣꯀꯦꯠ ꯑꯍꯨꯝ ꯍꯥꯌꯕꯁꯤ ꯌꯥꯝꯅꯥ ꯆꯥꯎꯕ ꯑꯁꯣꯏꯅꯤ꯫ ꯑꯁꯦꯡꯕ ꯕꯥꯏꯌꯥꯁ ꯑꯃꯥ ꯃꯇꯝ ꯌꯥꯝꯅꯥ ꯃꯁꯤꯒꯤ ꯁꯔꯨꯛ ꯈꯔꯈꯛꯇꯅꯤ, ꯑꯃꯁꯨꯡ ꯃꯁꯤꯕꯨ ꯂꯥꯛꯀꯤ ꯃꯍꯩꯗꯒꯤ ꯈꯦꯟꯅꯍꯟꯅꯕ ꯁ꯭ꯄꯤꯟ ꯂꯤꯁꯤꯡ ꯀꯌꯥ ꯃꯊꯧ ꯇꯥꯏ, ꯂꯃꯥꯏ ꯑꯁꯤꯅ ꯇꯥꯀꯄꯒꯨꯝꯅ꯫
ꯅꯣꯛꯅꯕꯒꯤ ꯀꯃꯤꯛ
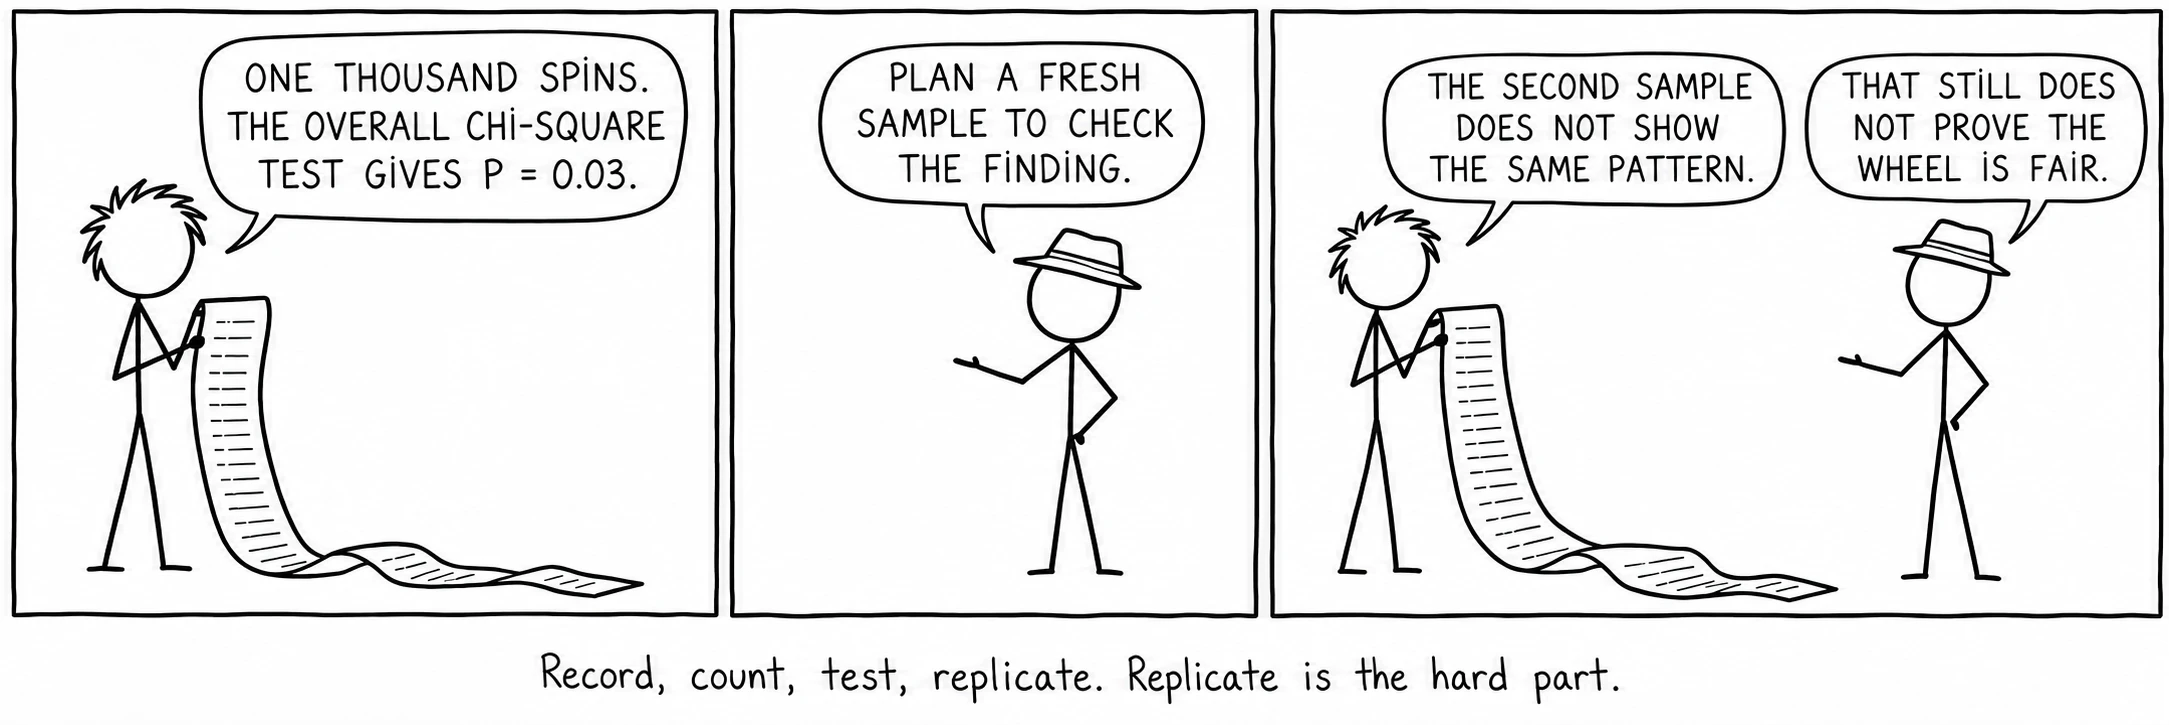
ꯏꯕ, ꯃꯁꯤꯡ ꯊꯤꯕ, ꯇꯦꯁ꯭ꯠ ꯇꯧꯕ, ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯕ꯫ ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯕ ꯑꯁꯤ ꯀꯟꯅꯕ ꯁꯔꯨꯛꯅꯤ꯫
ꯍꯧꯔꯛꯐꯃꯁꯤꯡ
- Pearson, K. “On the criterion that a given system of deviations from the probable…”
- Barnhart, R. T. Beating the Wheel.