ꯁ꯭ꯇꯦꯇꯤꯁ꯭ꯇꯤꯀꯦꯜ ꯁꯤꯒ꯭ꯅꯤꯐꯤꯀꯦꯟꯁ
“ꯃꯔꯨꯑꯣꯏꯕ” ꯍꯥꯌꯕꯁꯤ ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯗ ꯊꯣꯛꯅꯕ ꯌꯥꯝꯅ ꯍꯟꯊꯕ ꯍꯥꯌꯕꯅꯤ, “ꯑꯁꯦꯡꯕ” ꯍꯥꯌꯕ ꯅꯠꯇꯦ ꯑꯃꯁꯨꯡ “ꯀꯥꯟꯅꯕ ꯂꯩꯕ” ꯍꯥꯌꯕꯁꯨ ꯅꯠꯇꯦ꯫
p-ꯚꯦꯜꯌꯨ 0.05 ꯍꯥꯌꯕꯁꯤ ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯅ ꯑꯁꯤꯒꯨꯝꯅ ꯃꯥꯏꯀꯩ ꯑꯃꯗ ꯆꯦꯟꯊꯔꯕ ꯃꯑꯣꯡ ꯑꯃꯥ ꯑꯃꯨꯛ ꯀꯨꯟꯗ ꯑꯃꯨꯛ ꯄꯨꯊꯣꯛꯀꯅꯤ ꯍꯥꯌꯕꯅꯤ꯫ ꯆꯛꯔ ꯀꯨꯟ ꯌꯦꯡꯂꯕꯗ ꯑꯃꯅ ꯈꯪꯗꯅ ꯄꯥꯁ ꯇꯧꯒꯅꯤ꯫
p-ꯚꯦꯜꯌꯨ ꯍꯥꯌꯕꯁꯤ ꯀꯔꯤꯅꯣ
Assuming the stated null model, the p-valueꯂꯦꯕp-ꯚꯦꯜꯌꯨꯆꯛꯔ ꯑꯗꯨ ꯆꯨꯝꯃꯤꯟꯅꯔꯕꯗꯤ ꯎꯈꯤꯕ ꯑꯗꯨꯗꯒꯤ ꯍꯟꯊꯗꯕ ꯂꯥꯞꯊꯣꯛꯄ ꯑꯃꯥ ꯎꯕꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → is the probabilityꯃꯦꯊꯃꯦꯇꯤꯛꯁꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕꯃꯍꯩ ꯑꯃꯥ ꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ, 0 ꯗꯒꯤ 1 ꯐꯥꯑꯣꯕ ꯅꯠꯔꯒ 0% ꯗꯒꯤ 100% ꯐꯥꯑꯣꯕ꯫ ꯃꯁꯤꯡ ꯑꯃꯥ: 1/37 = 2.70%꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → of a test statistic at least as extreme as the observed one. It is not the probability that the wheel is fair or that the result arose by chance. Interpretation also depends on the design, assumptions and tests attempted.
ꯀꯌꯥ ꯆꯥꯡꯗꯝꯕ
ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯗ ꯅꯍꯥꯛꯅ ꯆꯂꯥꯏꯕ ꯇꯦꯁ꯭ꯠ ꯈꯨꯗꯤꯡꯃꯛꯇ 5% ꯂꯦꯚꯦꯂꯗ ꯄꯥꯁ ꯇꯧꯕꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ 5% ꯂꯩ꯫ ꯆꯛꯔ ꯀꯨꯟ ꯇꯦꯁ꯭ꯠ ꯇꯧꯔꯕꯗ ꯑꯃꯅ ꯄꯥꯁ ꯇꯧꯏ꯫ ꯆꯛꯔ ꯑꯃꯕꯨ ꯃꯇꯃꯒꯤ ꯁꯔꯨꯛ ꯀꯨꯟꯗ ꯇꯦꯁ꯭ꯠ ꯇꯧꯔꯕꯗ ꯑꯃꯅ ꯄꯥꯁ ꯇꯧꯏ꯫ ꯁꯦꯝꯄꯜ ꯑꯃꯕꯨ ꯄꯣꯀꯦꯠꯀꯤꯈꯨꯠꯂꯥꯏꯄꯣꯀꯦꯠꯔꯣꯇꯔꯗ ꯂꯩꯕ ꯃꯁꯤꯡ ꯏꯔꯕ ꯀꯣꯠ 37 ꯒꯤ ꯃꯅꯨꯡꯗ ꯑꯃꯥ꯫ ꯑꯇꯣꯞꯄ ꯃꯃꯤꯡ: ꯁ꯭ꯂꯣꯠ, ꯀꯞ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → ꯒ꯭ꯔꯨꯞ 37, ꯁꯦꯛꯇꯔꯒꯤꯆꯛꯔꯁꯦꯛꯇꯔꯆꯛꯔꯗ ꯃꯔꯛ ꯂꯩꯇꯅ ꯃꯈꯥ ꯆꯠꯅꯅ ꯂꯩꯕ ꯄꯣꯀꯦꯠꯁꯤꯡꯒꯤ ꯁꯔꯨꯛ, ꯂꯦꯑꯥꯎꯠꯇ ꯂꯩꯕ ꯀꯥꯡꯂꯨꯞ ꯑꯃꯗꯒꯤ ꯇꯣꯉꯥꯟꯅ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → ꯒ꯭ꯔꯨꯞ ꯇꯔꯨꯛ ꯑꯃꯁꯨꯡ ꯃꯆꯨꯒꯤ ꯒ꯭ꯔꯨꯞ ꯑꯍꯨꯃꯗ ꯇꯦꯁ꯭ꯠ ꯇꯧꯔꯕꯗ ꯀꯔꯤꯒꯨꯝꯕ ꯑꯃꯅ ꯄꯥꯁ ꯇꯧꯏ꯫ ꯃꯁꯤꯒꯤ ꯂꯥꯏꯌꯦꯡ ꯑꯗꯨꯗꯤ ꯗꯦꯇꯥ ꯌꯦꯡꯗ꯭ꯔꯤꯉꯩꯗ ꯇꯦꯁ꯭ꯠ ꯑꯗꯨ ꯂꯦꯞꯊꯣꯀꯄ, ꯑꯃꯨꯛ ꯈꯛ ꯆꯂꯥꯏꯕ, ꯑꯃꯁꯨꯡ ꯑꯅꯧꯕ ꯗꯦꯇꯥꯗ ꯁꯣꯏꯗꯅ ꯇꯥꯀꯄꯅꯤ꯫ “ꯕꯥꯏꯌꯥꯁ ꯂꯩꯕ” ꯆꯛꯔ ꯑꯃꯥ ꯊꯤꯗꯣꯛꯂꯤꯕ ꯌꯦꯡꯁꯤꯟꯕ ꯑꯗꯨꯅ ꯃꯇꯝ ꯌꯥꯝꯅ ꯃꯍꯩ ꯑꯗꯨ ꯄꯨꯊꯣꯀꯄꯅꯤ꯫
ꯃꯔꯨꯑꯣꯏꯕ ꯑꯃꯁꯨꯡ ꯆꯥꯡ
A large sample can detect a small departure from fairness that still does not make a bet profitable. At a true pocket probability of 1/36.5, a 35:1 bet has negative expectation. At 1/36 it breaks even. A p-value does not measure the size or practical value of an effect.
ꯄꯥꯋꯔ
Power is the chance of rejecting the null under a specified alternative. For one pocket chosen in advance, an exact one-sided 5% binomial test on 1,000 spins rejects at 37 or more hits. If the true rate is 1/30, its power is about 28%, not 50%.
ꯊꯕꯛꯇ ꯁꯤꯖꯤꯟꯅꯕ ꯌꯥꯕ ꯃꯥꯏꯄꯥꯀꯄꯒꯤ ꯊꯥꯛ
ꯕꯥꯏꯌꯥꯁꯀꯤ ꯋꯥꯐꯝ ꯑꯃꯥ ꯌꯦꯡꯁꯤꯟꯕꯒꯤ ꯃꯃꯜ ꯂꯩꯅꯕꯒꯤꯗꯃꯛ: ꯃꯃꯥꯡꯗ ꯈꯅꯈꯤꯕ ꯇꯦꯁ꯭ꯠ ꯑꯃꯥ, 0.05 ꯒꯤ ꯃꯍꯨꯠꯇ p < 0.01, ꯆꯥꯡ ꯃꯥꯟꯅꯕ ꯃꯔꯤ ꯂꯩꯅꯗꯕ ꯁꯦꯝꯄꯜ ꯑꯃꯗ ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯕ, ꯑꯃꯁꯨꯡ ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯔꯕꯥ ꯃꯇꯨꯡꯗ ꯍꯦꯟꯅꯥ ꯂꯥꯀꯄ ꯄꯣꯀꯦꯠꯁꯤꯡꯗ 1/34 ꯅꯠꯔꯒ ꯃꯁꯤꯗꯒꯤ ꯐꯕ ꯂꯥꯀꯄꯒꯤ ꯔꯦꯠ ꯑꯃꯥ꯫ ꯊꯥꯛ ꯑꯁꯤ ꯁꯥꯟꯅꯕ ꯑꯁꯤꯒꯤ ꯄꯨꯋꯥꯔꯤꯗ ꯑꯃꯨꯛ ꯈꯔꯈꯛ ꯐꯪꯈꯤ, ꯑꯃꯁꯨꯡ ꯃꯤꯌꯥꯃꯒꯤ ꯔꯦꯀꯣꯔꯗꯁꯤꯡꯅ ꯎꯠꯂꯤꯕ ꯐꯥꯑꯣꯕ, ꯌꯦꯡꯁꯤꯟꯂꯕ ꯑꯅꯧꯕ ꯆꯛꯔ ꯑꯃꯗ ꯀꯩꯗꯧꯉꯩꯗꯁꯨ ꯐꯪꯈꯤꯗꯦ꯫
ꯋꯥꯍꯪꯁꯤꯡ
1920 ꯁꯨꯕꯗꯒꯤ ꯂꯩꯔꯤꯕ ꯆꯠꯅꯕꯤꯅꯤ꯫ ꯃꯁꯤꯗ ꯑꯈꯟꯅꯕ ꯀꯔꯤꯁꯨ ꯂꯩꯇꯦ; ꯆꯛꯔ ꯀꯌꯥ ꯌꯦꯡꯁꯤꯟꯂꯤꯕ ꯃꯇꯃꯗ 0.01 ꯑꯁꯤ ꯍꯦꯟꯅꯥ ꯆꯨꯝꯕ ꯊꯥꯛ ꯑꯃꯅꯤ꯫
ꯃꯁꯤꯅ ꯃꯥꯟꯅꯕ ꯃꯍꯩꯁꯤꯡ ꯄꯤꯗꯕꯥ ꯌꯥꯏ꯫ ꯗꯤꯂꯔꯒꯤ ꯊꯧꯒꯜ, ꯏꯕꯗ ꯑꯔꯥꯟꯕ ꯅꯠꯔꯒ ꯗꯦꯇꯥ ꯆꯪꯍꯟꯕꯗ ꯁꯃꯁ꯭ꯌꯥ ꯑꯃꯥ ꯑꯣꯏꯕ ꯌꯥꯏ꯫ ꯑꯃꯨꯛ ꯍꯟꯅꯥ ꯇꯧꯕꯤꯌꯨ꯫
No. That requires a separate estimate of hit probability, its uncertainty and the actual payoutꯁꯦꯜꯄꯦꯑꯥꯎꯠꯃꯥꯏꯄꯥꯛꯄ ꯕꯦꯠ ꯑꯃꯅ ꯍꯜꯂꯛꯄ ꯁꯦꯜ, ꯍꯜꯂꯀꯄ ꯊꯝꯂꯕ ꯁꯦꯜꯒꯤ ꯃꯊꯛꯇ “X ꯗꯒꯤ 1” ꯍꯥꯌꯅ ꯍꯥꯌꯏ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ →.
ꯃꯦꯊꯃꯦꯇꯤꯛꯁꯀꯥ ꯁꯥꯟꯅꯕ
ꯃꯁꯤꯁꯤꯡ ꯑꯍꯥꯅꯕꯗ ꯅꯍꯥꯛ ꯃꯁꯥꯃꯛꯅ ꯍꯣꯠꯅꯕꯤꯌꯨ꯫ ꯄꯥꯎꯈꯨꯝ ꯈꯨꯗꯤꯡꯃꯛ ꯊꯨꯡꯗꯨꯅ ꯊꯝꯂꯤ; ꯁꯦꯝ ꯁꯥꯔꯕ ꯃꯇꯃꯗ ꯍꯥꯡꯗꯣꯛꯄꯤꯌꯨ꯫
Suppose a dozenꯕꯦꯠꯗꯖꯟ1–12, 13–24 ꯅꯠꯔꯒ 25–36, 2:1 ꯄꯦꯑꯥꯎꯠ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → chosen before data collection appears 742 times in 3,000 independent double-zeroꯆꯛꯔꯖꯤꯔꯣꯆꯞ ꯃꯥꯟꯅꯕ, ꯗꯖꯟ ꯅꯠꯔꯒ ꯀꯂꯝ ꯕꯦꯠ ꯑꯃꯠꯇꯅ ꯀꯨꯞꯇꯕ ꯑꯁꯪꯕ ꯄꯣꯀꯦꯠ ꯑꯃꯈꯛꯇ; ꯍꯥꯎꯁ ꯑꯦꯖꯀꯤ ꯍꯧꯔꯀꯐꯝꯅꯤ꯫ ꯑꯇꯣꯞꯄ ꯃꯃꯤꯡ: ꯁꯤꯡꯒꯜ ꯖꯤꯔꯣ, 0꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → spins. Under the uniform model, how many standard deviationsꯃꯦꯊꯃꯦꯇꯤꯛꯁꯁ꯭ꯇꯦꯟꯗꯔꯗ ꯗꯤꯚꯤꯌꯦꯁꯟꯚꯦꯌꯔꯤꯌꯦꯟꯁꯀꯤ ꯁ꯭ꯀ꯭ꯋꯦꯌꯔ ꯔꯨꯠ; ꯃꯍꯩ ꯑꯃꯅ ꯐꯪꯒꯗꯕ ꯃꯃꯜꯗꯒꯤ ꯌꯥꯝꯅ ꯂꯥꯞꯄ ꯃꯑꯣꯡ꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → below the mean is that? What is the probabilityꯃꯦꯊꯃꯦꯇꯤꯛꯁꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕꯃꯍꯩ ꯑꯃꯥ ꯊꯣꯛꯄꯒꯤ ꯈꯨꯗꯣꯡꯆꯥꯕ, 0 ꯗꯒꯤ 1 ꯐꯥꯑꯣꯕ ꯅꯠꯔꯒ 0% ꯗꯒꯤ 100% ꯐꯥꯑꯣꯕ꯫ ꯃꯁꯤꯡ ꯑꯃꯥ: 1/37 = 2.70%꯫ꯃꯄꯨꯡ ꯄꯥꯕꯤꯌꯨ → of 742 or fewer hits?
ꯄꯥꯎꯈꯨꯝ ꯎꯠꯄ
ꯄꯥꯎꯈꯨꯝ ꯁ꯭ꯇꯦꯟꯗꯔꯗ ꯗꯤꯚꯤꯌꯦꯁꯟ 8.1 ꯈꯔ ꯃꯈꯥꯗ꯫ ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯑꯃꯅ ꯃꯁꯤ ꯍꯣꯠꯅꯕ 3 × 10¹⁵ ꯗ ꯑꯃꯨꯛ ꯈꯔ ꯇꯧꯒꯅꯤ, ꯍꯥꯌꯕꯗꯤ ꯀꯩꯗꯧꯉꯩꯗꯁꯨ ꯅꯠꯇꯦ꯫ ꯋꯥꯍꯪ ꯑꯗꯨꯒꯥ ꯂꯣꯌꯅꯅ ꯐꯣꯡꯗꯣꯀꯈꯤꯕ ꯄꯥꯎꯈꯨꯃꯅ 11.75 ꯍꯥꯌꯔꯤ; ꯑꯩꯈꯣꯌꯅ 8.07 ꯐꯪꯏ꯫
Under the stated model, X is binomial with n = 3,000 and p = 12/38. Its mean is np ≈ 947.37 and its standard deviation is √(np(1 − p)) ≈ 25.46.
The standardized difference is (742 − 947.37)/25.46 ≈ −8.07. Summing the exact binomial probabilities from 0 through 742 gives P(X ≤ 742) ≈ 9.77 × 10⁻¹⁷. A normal approximation with continuity correction gives about 4.25 × 10⁻¹⁶; the relative error is large this far into the tail.
This is the probability of the specified data event under the model, not the probability that the wheel is fair. Such a result calls for checking the observations, independence, uniformity and analysis plan. Selecting the worst-looking dozen after inspecting data, or searching many wheels or time periods, requires accounting for that selection.
ꯅꯣꯛꯅꯕꯒꯤ ꯀꯃꯤꯛ
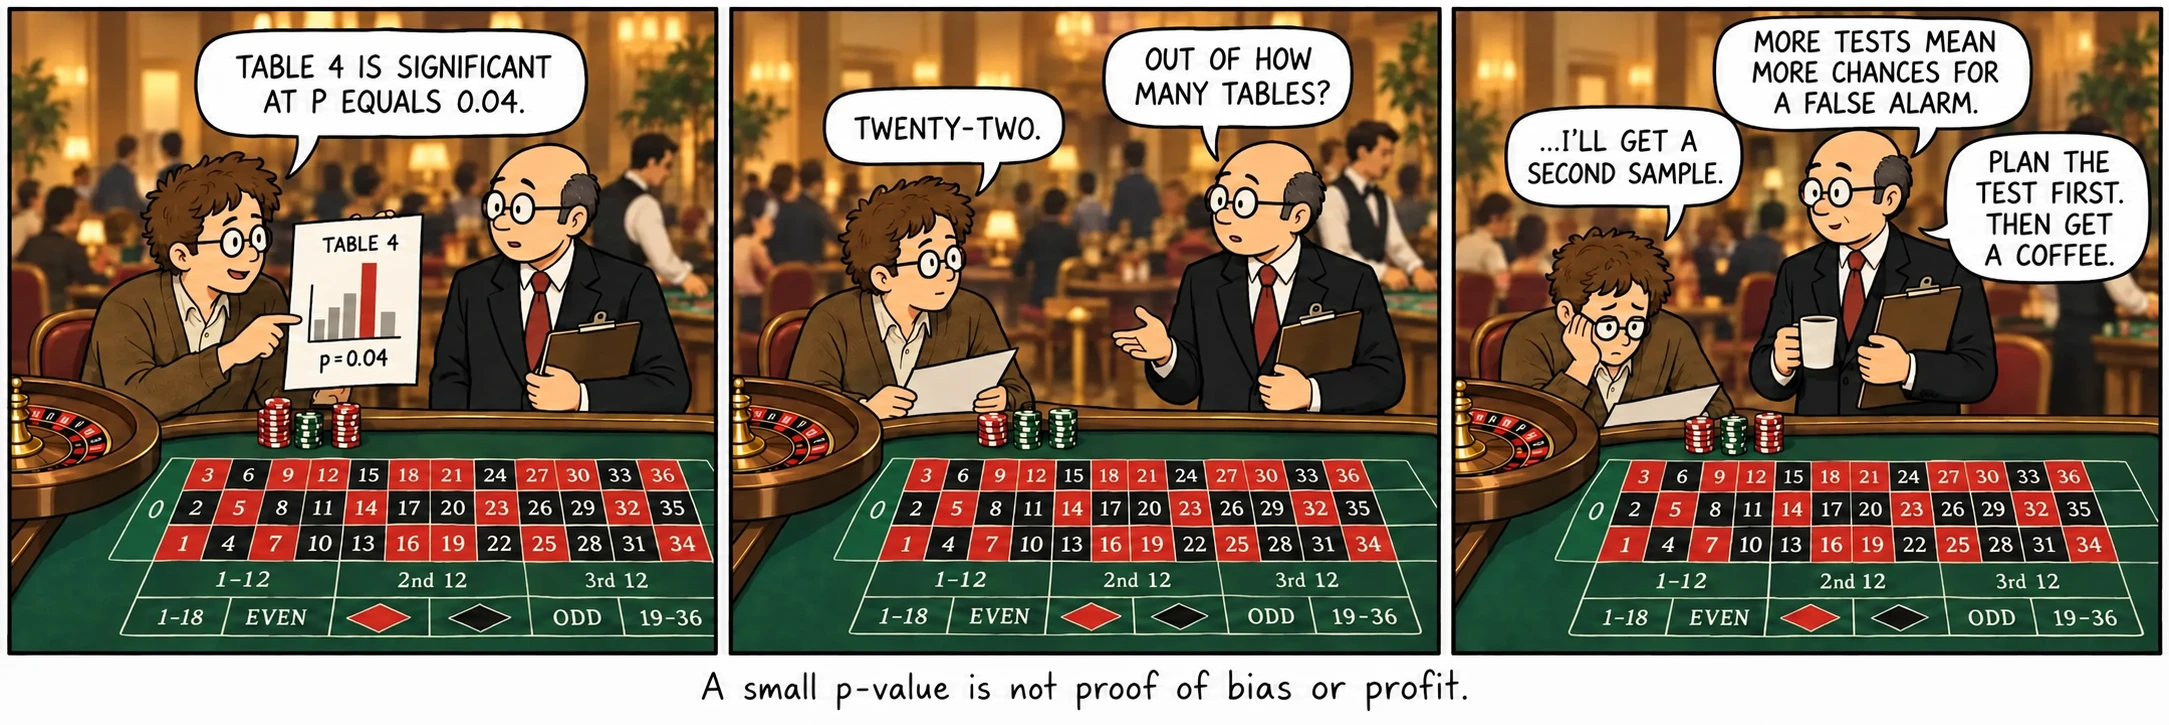
ꯆꯨꯝꯃꯤꯟꯅꯕ ꯆꯛꯔ ꯀꯨꯟꯗ ꯑꯃꯥ “ꯃꯔꯨꯑꯣꯏꯕ” ꯑꯣꯏ꯫ ꯃꯁꯤꯡ ꯑꯗꯨꯒꯤ ꯑꯔꯊ ꯑꯗꯨ ꯃꯁꯤꯅꯤ꯫
ꯍꯧꯔꯛꯐꯃꯁꯤꯡ
- Pearson, K. “On the criterion that a given system of deviations from the probable…”
- Feller, W. An Introduction to Probability Theory and Its Applications, Vol. 1.